
一生一芯学习记录(E 阶段)(二)
这是E2阶段的最后一部分内容,接下来将会回到E1学习硬件描述语言。由于在这个阶段我们所用是在线编译器,因此部分习题无法解答。
E2 C语言程序设计
在学习完C语言入门部分之后,接下来几章内容将逐渐探究C语言的本质。
第14章:计算机中数的表示
这章的大部分内容在F 阶段学习数字电路的时候已经学习过,下面只对习题部分和浮点数进行记录。
2 不同进制的换算
习题1:二进制小数可以这样定义: 这个定义同时也是从二进制小数到十进制小数的换算公式。从本节讲的十进制转二进制的推导过程出发类比一下,十进制小数换算成二进制小数应该怎么算?
十进制小数转二进制小数只需要每次将小数部分乘以2,积的整数部分就是二进制小数的一位,剩下的小数部分继续乘以2,直到小数部分为0,或者达到想要的精度。
习题2:再类比一下,八进制(或十六进制)与十进制之间如何相互换算?
类似于二进制与十进制的换算:
- 八进制(十六进制)转十进制:每位加权求和。
- 十进制转八进制(十六进制):除8(或16)取余。
4 浮点数
浮点数在计算机中的表示是基于科学计数法(Scientific Notation)的,我们知道32767这个数用科学计数法可以写成 ,3.2767称为尾数(Mantissa,或者叫Significand),4称为指数(Exponent)。浮点数在计算机中的表示与此类似,只不过基数(Radix)是2而不是10。
下面我们用一个简单的模型来解释浮点数的基本概念。我们的模型由三部分组成:符号位、指数部分(表示2的多少次方)和尾数部分(小数点前面是0,尾数部分只表示小数点后的数字)。
 sign bit     exponent      significand
|  1 bit  |    5 bits   |     8 bits     |
如果要表示17这个数,我们知道 ,类似地,,把尾数的有效数字全部移到小数点后,这样就可以表示为:
 sign bit     exponent      significand
|    0    |    00101   |     10001000     |
如果我们要表示0.25就遇到新的困难了,因为 ,而我们的模型中指数部分没有规定如何表示负数。我们可以在指数部分规定一个符号位,然而更广泛采用的办法是使用偏移的指数(Biased Exponent)。规定一个偏移值,比如16,实际的指数要加上这个偏移值再填写到指数部分,这样比16大的就表示正指数,比16小的就表示负指数。要表示0.25,指数部分应该填16-1=15:
 sign bit     exponent      significand
|    0    |    01111   |     10000000     |
现在还有一个问题需要解决:每个浮点数的表示都不唯一,例如 ,这样给计算机处理增加了复杂性。为了解决这个问题,我们规定尾数部分的最高位必须是1,也就是说尾数必须以0.1开头,对指数做相应的调整,这称为正规化(Normalize)。由于尾数部分的最高位必须是1,这个1就不必保存了,可以节省出一位来用于提高精度,我们说最高位的1是隐含的(Implied)。这样17就只有一种表示方法了,指数部分应该是 ,尾数部分去掉最高位的1是0001:
 sign bit     exponent      significand
|    0    |    10101   |     00010000     |
正是因为位数限制的问题,因此浮点运算时要注意精度损失(Significance Loss)问题,有时计算顺序不同也会导致不同的结果。
第15章:数据类型详解
1 整型
在C语言中
char型占一个字节的存储空间,一个字节通常是8个bit。如果这8个bit按无符号整数来解释,取值范围是0~255,如果按有符号整数来解释,采用2’s Complement表示法,取值范围是-128~127。C语言规定了signed和unsigned两个关键字,unsigned char型表示无符号数,signed char型表示有符号数。注意,ASCII码的取值范围是0~127,所以不管
char型是有符号的还是无符号的,存一个ASCII码都没有问题,一般来说,如果用char型存ASCII码字符,就不必明确写是signed还是unsigned,如果用char型表示8位的整数,为了可移植性就必须写明是signed还是unsigned。除了
char型之外,整型还包括short int(或者简写为short)、int、long int(或者简写为long)、long long int(或者简写为long long)等几种,这些类型都可以加上signed或unsigned关键字表示有符号或无符号数。还有一点要注意,除了
char型以外的这些类型如果不明确写signed或unsigned关键字都表示signed,这一点是C标准明确规定的,不是Implementation Defined。除了
char型在C标准中明确规定占一个字节之外,其它整型占几个字节都是Implementation Defined。通常的编译器实现遵守ILP32或LP64规范,如下表所示。
类型 ILP32(位数) LP64(位数) char 8 8 short 16 16 int 32 32 long 32 64 long long 64 64 指针 32 64 ILP32这个缩写的意思是
int(I)、long(L)和指针(P)类型都占32位,通常32位计算机的C编译器采用这种规范,x86平台的gcc也是如此。LP64是指long(L)和指针占64位,通常64位计算机的C编译器采用这种规范。八进制整数常量以0开头,后面的数字只能是0~7,例如022,因此十进制的整数常量就不能以0开头了,否则无法和八进制区分。十六进制整数常量以0x或0X开头,后面的数字可以是0~9、a~f和A~F。
后缀 十进制常量 八进制或十六进制常量 无 int
long int
long long intint
unsigned int
long int
unsigned long int
long long int
unsigned long long intu或U unsigned int
unsigned long int
unsigned long long intunsigned int
unsigned long int
unsigned long long intI或L long int
long long intlong int
unsigned long int
long long int
unsigned long long int既有u或U,又有I或L unsigned long int
unsigned long long intunsigned long int
unsigned long long intII或LL long long int long long int
unsigned long long int既有u或U,又有II或LL unsigned long long int unsigned long long int
2 浮点型
C标准规定的浮点型有
float、double、long double,和整型一样,既没有规定每种类型占多少字节,也没有规定采用哪种表示形式。浮点数的实现在各种平台上差异很大,有的处理器有浮点运算单元(FPU,Floating Point Unit),称为硬浮点(Hard-float)实现;有的处理器没有浮点运算单元,只能做整数运算,需要用整数运算来模拟浮点运算,称为软浮点(Soft-float)实现。大部分平台的浮点数实现遵循IEEE 754,float型通常是32位,double型通常是64位。以前我们只用到最简单的浮点数常量,例如3.14,现在看看浮点数常量还有哪些写法。由于浮点数在计算机中的表示是基于科学计数法的,所以浮点数常量也可以写成科学计数法的形式,尾数和指数之间用e或E隔开,例如314e-2表示 ,注意这种表示形式基数是10。
浮点数的后缀和类型之间的对应关系比较简单,没有后缀的浮点数常量是
double型的,有后缀f或F的浮点数常量是float型的,有后缀l或L的浮点数常量是long double型的。
3 类型转换
3.1 Integer Promotion
在一个表达式中,凡是可以使用
int或unsigned int类型做右值的地方也都可以使用有符号或无符号的char型、short型和Bit-field。如果原始类型的取值范围都能用int型表示,则其类型被提升为int,如果原始类型的取值范围用int型表示不了,则提升为unsigned int型,这称为Integer Promotion。做Integer Promotion只影响上述几种类型的值,对其它类型无影响。C99规定Integer Promotion适用于以下几种情况:
- 如果一个函数的形参类型未知,例如使用了Old Style C风格的函数声明,或者函数的参数列表中有
...,那么调用函数时要对相应的实参做Integer Promotion,此外,相应的实参如果是float型的也要被提升为double型,这条规则称为Default Argument Promotion。- 算术运算中的类型转换。有符号或无符号的
char型、short型和Bit-field在做算术运算之前首先要做Integer Promotion,然后才能参与计算。
3.2 Usual Arithmetic Conversion
两个算术类型的操作数做算术运算,比如
a + b,如果两边操作数的类型不同,编译器会自动做类型转换,使两边类型相同之后才做运算,这称为Usual Arithmetic Conversion。转换规则如下:
- 如果有一边的类型是
long double,则把另一边也转成long double。- 否则,如果有一边的类型是
double,则把另一边也转成double。- 否则,如果有一边的类型是
float,则把另一边也转成float。- 否则,两边应该都是整型,首先按上一小节讲过的规则对
a和b做Integer Promotion,然后如果类型仍不相同,则需要继续转换。首先我们规定char、short、int、long、long long的转换级别(Integer Conversion Rank)一个比一个高,同一类型的有符号和无符号数具有相同的Rank。转换规则如下:
- 如果两边都是有符号数,或者都是无符号数,那么较低Rank的类型转换成较高Rank的类型。
- 否则,如果一边是无符号数另一边是有符号数,无符号数的Rank不低于有符号数的Rank,则把有符号数转成另一边的无符号类型。
- 剩下的情况是:一边有符号另一边无符号,并且无符号数的Rank低于有符号数的Rank。这时又分为两种情况,如果这个有符号数类型能够覆盖这个无符号数类型的取值范围,则把无符号数转成另一边的有符号类型。
- 否则,也就是这个有符号数类型不足以覆盖这个无符号数类型的取值范围,则把两边都转成有符号数的Rank对应的无符号类型。
到目前为止我们学过的
+-*/%><>=<===!=运算符都需要做Usual Arithmetic Conversion,因为都要求两边操作数的类型一致,在下一章会介绍几种新的运算符也需要做Usual Arithmetic Conversion。单目运算符+-~只有一个操作数,移位运算符<<>>两边的操作数类型不要求一致,这些运算不需要做Usual Arithmetic Conversion,但也需要做Integer Promotion,运算符~<<>>将在下一章介绍。
3.3 由赋值产生的类型转换
如果赋值或初始化时等号两边的类型不相同,则编译器会把等号右边的类型转换成等号左边的类型再做赋值。
函数调用传参的过程相当于定义形参并且用实参对其做初始化,函数返回的过程相当于定义一个临时变量并且用
return的表达式对其做初始化,所以由赋值产生的类型转换也适用于这两种情况。
3.4 强制类型转换
以上三种情况通称为隐式类型转换(Implicit Conversion,或者叫Coercion),编译器根据它自己的一套规则将一种类型自动转换成另一种类型。除此之外,程序员也可以通过类型转换运算符(Cast Operator)自己规定某个表达式要转换成何种类型,这称为显式类型转换(Explicit Conversion)或强制类型转换(Type Cast)。
第16章:运算符详解
1 位运算
整数在计算机中用二进制的位来表示,C语言提供一些运算符可以直接操作整数中的位,称为位运算,这些运算符的操作数都必须是整型的。
1.1 按位与、或、异或、取反运算
C语言提供了按位与(Bitwise AND)运算符
&、按位或(Bitwise OR)运算符|和按位取反(Bitwise NOT)运算符~,此外还有按位异或(Bitwise XOR)运算符^。
1.2 移位运算
移位运算符(Bitwise Shift)包括左移
<<和右移>>。移动的位数必须小于左操作数的总位数。
当操作数是有符号数时,右移运算的规则比较复杂:
- 如果是正数,那么高位移入0。
- 如果是负数,那么高位移入1还是0不一定,这是Implementation-defined的。
综上所述,由于类型转换和移位等问题,用有符号数做位运算是很不方便的,所以,建议只对无符号数做位运算,以减少出错的可能。
习题1:下面两行printf打印的结果有何不同?请读者比较分析一下。
int i = 0xcffffff3;
printf("%x\n", 0xcffffff3>>2);
printf("%x\n", i>>2);
%x是将一个整数转换为十六进制表示的字符串。最终输出第一行是33fffffc,第二行是f3fffffc,由于第一行0xcffffff3是无符号数,因此移位时在最前面补两个0;而第二行中的i的格式为int类型,是有符号数,编译器处理移位时在最高位补两个1。
1.3 掩码
如果要对一个整数中的某些位进行操作,怎样表示这些位在整数中的位置呢?可以用掩码(Mask)来表示。比如掩码0x0000ff00表示对一个32位整数的8~15位进行操作。
其实就是用掩码和逻辑结合移位来实现对位进行操作。
习题1:统计一个无符号整数的二进制表示中1的个数,函数原型是
int countbit(unsigned int x);。
这个程序思路比较简单,每次检查最低位是不是1即可,如果是,就进行计数,然后对原来的整数右移一位;不是的话直接移位,最后返回计数值即可。
int countbit(unsigned int x)
{
    int i = 0;
    while(x != 0){
        if((x & 1) == 1){
            i++;
        }
        x = (x >> 1);
    }
    return i;
}
习题2:用位操作实现无符号整数的乘法运算,函数原型是
unsigned int multiply(unsigned int x, unsigned int y);。例如:。
同样运用移位检查y中每个1所在的位置,之后对x进行相应的移位,最后累加求和即可。
unsigned int multiply(unsigned int x, unsigned int y)
{
    unsigned int result = 0;
    int i = 0;
    while (y != 0){
        if(y & 1){
            result = result + (x << i);
        }
        y = y >> 1;
        i++;
    }
    return result;
}
习题3:对一个32位无符号整数做循环右移,函数原型是
unsigned int rotate_right(unsigned int x,unsigned int n);。所谓循环右移就是把低位移出去的部分再补到高位上去,例如rotate_right(0xdeadbeef, 8)的值应该是0xefdeadbe。
原文中的题干实际上有问题,现在文章中的题干是修改后的。这个题实际上也是判断最低位是0或1,然后采用不同的处理方式,如果是0,就直接移位即可;如果是1,则移位后需要与0x80000000按位取或。
unsigned int rotate_right(unsigned int x, unsigned int n)
{
    unsigned int i;
    for (i = 0; i < n; i++){
        if ((x & 1) == 1){
            x = (x >> 1) | 0x80000000;
        }
        else x = (x >> 1);
    }
    return x;
}
1.4 异或运算的一些特性
- 一个数和自己做异或的结果是0。这种指令运算会更快。
- 从异或的真值表可以看出,不管是0还是1,和0做异或保持原值不变,和1做异或得到原值的相反值。可以利用这个特性配合掩码实现某些位的翻转。
- 如果 ^ ^ ^ … ^ 的结果是1,则表示 、、… 之中1的个数为奇数个,否则为偶数个。这条性质可用于奇偶校验(Parity Check),比如在串口通信过程中,每个字节的数据都计算一个校验位,数据和校验位一起发送出去,这样接收方可以根据校验位粗略地判断接收到的数据是否有误。
x ^ x ^ y == y,因为x ^ x == 0,0 ^ y == y。这个方法可以用来交换两个变量的值。利用位运算可以这样做交换:ca = a ^ b; b = b ^ a; a = a ^ b;
习题2:交换两个变量的值,不得借助额外的存储空间,除了本节讲的方法之外你还能想出什么方法?本节讲的方法不能把同一个变量自己跟自己交换,你的方法有没有什么局限性?
利用加减法也可以实现交换两个变量的值:
a = a + b;
b = a - b;
a = a - b;这种方法的局限性在于需要考虑a + b可能会超出存储空间。
2 其他运算符
2.1 复合赋值运算符
复合赋值运算符(Compound Assignment Operator)包括
*=/=%=+=-=<<=>>=&=^=|=,一边做运算一边赋值。例如a += 1相当于a = a + 1。但有一点细微的差别,前者对表达式a只求值一次,而后者求值两次,如果a是一个复杂的表达式,求值一次和求值两次的效率是不同的,例如a[i+j] += 1和a[i+j] = a[i+j] + 1。那么仅仅是效率上的差别吗?对于没有Side Effect的表达式,求值一次和求值两次的结果是一样的,但对于有Side Effect的表达式则不一定,例如a[foo()] += 1和a[foo()] = a[foo()] + 1,如果foo()函数调用有Side Effect,比如会打印一条消息,那么前者只打印一次,而后者打印两次。
2.2 条件运算符
条件运算符(Conditional Operator)是C语言中唯一一个三目运算符(Ternary Operator),带三个操作数,它的形式是
表达式1 ? 表达式2 : 表达式3,这个运算符所组成的整个表达式的值等于表达式2或表达式3的值,取决于表达式1的值是否为真,可以把它想像成这样的函数:cif (表达式1) return 表达式2; else return 表达式3;表达式1相当于if语句的控制表达式,因此它的值必须是标量类型,而表达式2和3相当于同一个函数在不同情况下的返回值,因此它们的类型要求一致,也要做Usual Arithmetic Conversion。
2.3 逗号运算符
逗号运算符(Comma Operator)也是一种双目运算符,它的形式是
表达式1, 表达式2,两个表达式不要求类型一致,左边的表达式1先求值,求完了直接把值丢掉,再求右边表达式2的值作为整个表达式的值。逗号运算符是左结合的,类似于+-*/运算符,根据组合规则可以写出表达式1, 表达式2, 表达式3, ..., 表达式n这种形式,表达式1, 表达式2可以看作一个子表达式,先求表达式1的值,然后求表达式2的值作为这个子表达式的值,然后这个值再和表达式3组成一个更大的表达式,求表达式3的值作为这个更大的表达式的值,依此类推,整个计算过程就是从左到右依次求值,最后一个表达式的值成为整个表达式的值。
2.4 sizeof运算符与typedef类型声明
sizeof是一个很特殊的运算符,它有两种形式:sizeof 表达式和sizeof(类型名)。这个运算符很特殊,sizeof 表达式中的子表达式并不求值,而只是根据类型转换规则求得子表达式的类型,然后把这种类型所占的字节数作为整个表达式的值。
sizeof运算符的结果是size_t类型的,这个类型定义在stddef.h头文件中,不过你的代码中只要不出现size_t这个类型名就不用包含这个头文件。
typedef这个关键字用于给某种类型起个新名字,类型名也遵循标识符的命名规则,并且通常加个_t后缀表示Type。
4 运算符总结
运算符
+-*/%><>=<===!=&|^以及各种复合赋值运算符要求两边的操作数类型一致,条件运算符?:要求后两个操作数类型一致,这些运算符在计算之前都需要做Usual Arithmetic Conversion。下面按优先级从高到低的顺序总结一下C语言的运算符,每一条所列的各运算符具有相同的优先级,对于同一优先级的多个运算符按什么顺序计算也有说明,双目运算符就简单地用“左结合”或“右结合”来说明了。和指针有关的运算符* & ->也在这里列出来了。
- 标识符、常量、字符串和用
()括号套起来的表达式是组成表达式的最基本单元,在运算中做操作数,优先级最高。- 后缀运算符,包括数组取下标
[]、函数调用()、结构体取成员.、指向结构体的指针取成员->、后缀自增++、后缀自减--。如果一个操作数后面有多个后缀,按照离操作数从近到远的顺序(也就是从左到右)依次计算。- 单目运算符,包括前缀自增
++、前缀自减--、sizeof、类型转换()、取地址运算&、指针间接寻址*、正号+、负号-、按位取反~、逻辑非!。如果一个操作数前面有多个前缀,按照离操作数从近到远的顺序(也就是从右到左)依次计算。- 乘
*、除/、模%运算符。这三个运算符是左结合的。- 加
+、减-运算符。左结合。- 移位运算符
<<和>>。左结合。- 关系运算符
<><=>=。左结合。- 相等性运算符
==和!=。左结合。- 按位与
&。左结合。- 按位异或
^。左结合。- 按位或
|。左结合。- 逻辑与
&&。左结合。- 逻辑或
||。左结合。- 条件运算符
?:。- 赋值
=和各种复合赋值(*=/=%=+=-=<<=>>=&=^=|=)。在双目运算符中只有赋值和复合赋值是右结合的。- 逗号运算符。左结合。
习题1:以下代码得到的
sum是0xffff,对吗?cint i = 0; unsigned int sum = 0; for (; i < 16; i++) sum = sum + 1U<<i;
不对,按照运算符的优先级,先进行加法运算,后进行移位计算。
第21章:预处理
1 预处理的步骤
现在我们全面了解一下C编译器做语法解析之前的预处理步骤:
- 把三连符替换成相应的单字符。
- 把用
\字符续行的多行代码接成一行。- 把注释(不管是单行注释还是多行注释)都替换成一个空格。
- 经过以上两步之后去掉了一些换行,有的换行在续行过程中去掉了,有的换行在多行注释之中,也随着注释一起去掉了,剩下的代码行称为逻辑代码行。然后预处理器把逻辑代码行划分成Token和空白字符,这时的Token称为预处理Token,包括标识符、整数常量、浮点数常量、字符常量、字符串、运算符和其它符号。
- 在Token中识别出预处理指示,做相应的预处理动作,如果遇到
#include预处理指示,则把相应的源文件包含进来,并对源文件做以上1-4步预处理。如果遇到宏定义则做宏展开。预处理指示的定义如下:一条预处理指示由一个逻辑代码行组成,以#开头,后面跟若干个预处理Token,在预处理指示中允许使用的空白字符只有空格和Tab。- 找出字符常量或字符串中的转义序列,用相应的字节来替换它。
- 把相邻的字符串连接起来。
- 经过以上处理之后,把空白字符丢掉,把Token交给C编译器做语法解析,这时就不再是预处理Token,而称为C Token了。这里丢掉的空白字符包括空格、换行、水平Tab、垂直Tab、分页符。注意,把一个预处理指示写成多行要用
\续行,因为根据定义,一条预处理指示只能由一个逻辑代码行组成,而把C代码写成多行则不需要用\续行,因为换行在C代码中只不过是一种空白字符,在做语法解析时所有空白字符都已经丢掉了。
2 宏定义
2.1 函数式宏定义
以前我们用过的
#define N 20或#define STR "hello, world"这种宏定义可以称为变量式宏定义(Object-like Macro),宏定义名可以像变量一样在代码中使用。另外一种宏定义可以像函数调用一样在代码中使用,称为函数式宏定义(Function-like Macro)。注意这种函数式宏定义和真正的函数调用有什么不同:
- 函数式宏定义的参数没有类型,预处理器只负责做形式上的替换,而不做参数类型检查,所以传参时要格外小心。
- 调用真正函数的代码和调用函数式宏定义的代码编译生成的指令不同。
- 调用函数时先求实参表达式的值再传给形参,如果实参表达式有Side Effect,那么这些Side Effect只发生一次。
- 即使实参没有Side Effect,使用函数式宏定义也往往会导致较低的代码执行效率。
尽管函数式宏定义和真正的函数相比有很多缺点,但只要小心使用还是会显著提高代码的执行效率,毕竟省去了分配和释放栈帧、传参、传返回值等一系列工作,因此那些简短并且被频繁调用的函数经常用函数式宏定义来代替实现。
如果在一个程序文件中重复定义一个宏,C语言规定这些重复的宏定义必须一模一样。在定义的前后多些空白(空格、Tab、注释)没有关系,在定义之中多些空白或少些空白也没有关系,但在定义之中有空白和没有空白被认为是不同的。如果需要重新定义一个宏,和原来的定义不同,可以先用
#undef取消原来的定义,再重新定义。
2.2 内联函数
C99引入一个新关键字
inline,用于定义内联函数(inline function)。inline关键字告诉编译器,这个函数的调用要尽可能快,可以当普通的函数调用实现,也可以用宏展开的办法实现。
2.3 #、##运算符和可变函数
在函数式宏定义中,
#运算符用于创建字符串,#运算符后面应该跟一个形参(中间可以有空格或Tab)。注意如果实参中包含字符常量或字符串,则宏展开之后字符串的界定符
"要替换成\",字符常量或字符串中的\和"字符要替换成\\和\"。在宏定义中可以用
##运算符把前后两个预处理Token连接成一个预处理Token,和#运算符不同,##运算符不仅限于函数式宏定义,变量式宏定义也可以用。我们知道
printf函数带有可变参数,函数式宏定义也可以带可变参数,同样是在参数列表中用...表示可变参数。在宏定义中,可变参数的部分用__VA_ARGS__表示,实参中对应...的几个参数可以看成一个参数替换到宏定义中__VA_ARGS__所在的地方。调用函数式宏定义允许传空参数,这一点和函数调用不同。
3 条件预处理指示
常见的条件预处理指示有:#ifdef,#ifndef,endif等。
4 其他预处理特性
#pragma预处理指示供编译器实现一些非标准的特性,C标准没有规定#pragma后面应该写什么以及起什么作用,由编译器自己规定。有的编译器用#pragma定义一些特殊功能寄存器名,有的编译器用#pragma定位链接地址,本书不做深入讨论。如果编译器在代码中碰到不认识的#pragma指示则忽略它,例如gcc的#pragma指示都是#pragma GCC ...这种形式,用别的编译器编译则忽略这些指示。C标准规定了几个特殊的宏,在不同的地方使用可以自动展开成不同的值,常用的有
__FILE__和__LINE__,__FILE__展开为当前源文件的文件名,是一个字符串,__LINE__展开为当前代码行的行号,是一个整数。这两个宏在源代码中不同的位置使用会自动取不同的值,显然不是用#define能定义得出来的,它们是编译器内建的特殊的宏。在打印调试信息时除了文件名和行号之外还可以打印出当前函数名,C99引入一个特殊的标识符
__func__支持这一功能。这个标识符应该是一个变量名而不是宏定义,不属于预处理的范畴,但它的作用和__FILE__、__LINE__类似,所以放在一起讲。
第23章:指针
1 指针的基本概念
这里的
&是取地址运算符(Address Operator),&i表示取变量i的地址,int *pi = &i;表示定义一个指向int型的指针变量pi,并用i的地址来初始化pi。如果要让
pi指向另一个整型变量j,可以重新对pi赋值:pi = &j;。如果要改变
pi所指向的整型变量的值,比如把变量j的值增加10,可以写:*pi = *pi + 10;,这里的*号是指针间接寻址运算符(Indirection Operator),*pi表示取指针pi所指向的变量的值,也称为Dereference操作,指针有时称为变量的引用(Reference),所以根据指针找到变量称为Dereference。
&运算符的操作数必须是左值,因为只有左值才表示一个内存单元,才会有地址,运算结果是指针类型。*运算符的操作数必须是指针类型,运算结果可以做左值。如果
pi是int *型的,pc是char *型的,现在pi指向的地址和pc一样,则通过*pc只能访问到一个字节,而通过*pi可以访问到4个字节。指向不确定地址的指针称为“野指针”(Unbound Pointer),为避免出现野指针,在定义指针变量时就应该给它明确的初值,或者把它初始化为
NULL。在编程时经常需要一种通用指针,可以转换为任意其它类型的指针,任意其它类型的指针也可以转换为通用指针,最初C语言没有
void *类型,就把char *当通用指针,需要转换时就用类型转换运算符(),ANSI在将C语言标准化时引入了void *类型,void *指针与其它类型的指针之间可以隐式转换,而不必用类型转换运算符。注意,只能定义void *指针,而不能定义void型的变量,因为void *指针和别的指针一样都占4个字节,而如果定义void型变量(也就是类型暂时不确定的变量),编译器不知道该分配几个字节给变量。同样道理,void *指针不能直接Dereference,而必须先转换成别的类型的指针再做Dereference。void *指针常用于函数接口。
2 指针类型的参数和返回值
习题2:现在回头看“形参和实参”的习题1,那个程序应该怎么改?
首先将那个习题引用过来,即能实现increment函数,将传进来的参数加1:
void increment(int x)
{
	x = x + 1;
}

int main(void)
{
	int i = 1, j = 2;
	increment(i); /* i now becomes 2 */
	increment(j); /* j now becomes 3 */
	return 0;
}修改之后如下,即将increment的参数改为指针,指向main函数中的参数所在的地址。
#include <stdio.h>

void increment(int *px)
{
	*px = *px + 1;

}

int main(void)
{
	int i = 1, j = 2;
	increment(&i); /* i now becomes 2 */
	increment(&j); /* j now becomes 3 */
    printf("i=%d,j=%d\n",i,j);
	return 0;
}
3 指针与数组
指针之间的比较运算比的是地址,C语言正是这样规定的,不过C语言的规定更为严谨,只有指向同一个数组中元素的指针之间相互比较才有意义,否则没有意义。指针相减表示两个指针之间相差的元素个数,同样只有指向同一个数组中元素的指针之间相减才有意义。C语言也规定两个指针不能相加。
4 指针与const限定符
const限定符和指针结合起来常见的情况有以下几种:cconst int *a; int const *a;这两种写法是一样的,
a是一个指向const int型的指针,a所指向的内存单元不可改写,所以(*a)++是不允许的,但a可以改写,所以a++是允许的。cint * const a;
a是一个指向int型的const指针,*a是可以改写的,但a不允许改写。cint const * const a;
a是一个指向const int型的const指针,因此*a和a都不允许改写。
6 指向指针的指针与指针数组
习题1:想想以下定义中的
const分别起什么作用?编写程序验证你的猜测。cconst char **p; char *const *p; char **const p;
const char **p;定义了一个指向const char型指针的指针,p和*p都可以改变,但是**p不能改变。char *const *p;是一个指向char型指针的const指针,因此*p不能改变,p和**p可以改变。char **const p;则是一个指向char型指针的指针,但是被const限制了,所以p不能改变,但是*p和**p都可以。
7 指向数组的指针与多维数组
现在看指向数组的指针如何使用:
cint a[10]; int (*pa)[10] = &a;
a是一个数组,在&a这个表达式中,数组名做左值,取整个数组的首地址赋给指针pa。注意,&a[0]表示数组a的首元素的首地址,而&a表示数组a的首地址,显然这两个地址的数值相同,但这两个表达式的类型是两种不同的指针类型,前者的类型是int *,而后者的类型是int (*)[10]。*pa就表示pa所指向的数组a,所以取数组的a[0]元素可以用表达式(*pa)[0]。注意到*pa可以写成pa[0],所以(*pa)[0]这个表达式也可以改写成pa[0][0]。
习题1:定义以下变量:
cchar a[4][3][2] = {{{'a', 'b'}, {'c', 'd'}, {'e', 'f'}}, {{'g', 'h'}, {'i', 'j'}, {'k', 'l'}}, {{'m', 'n'}, {'o', 'p'}, {'q', 'r'}}, {{'s', 't'}, {'u', 'v'}, {'w', 'x'}}}; char (*pa)[2] = &a[1][0]; char (*ppa)[3][2] = &a[1];要想通过
pa或ppa访问数组a中的'r'元素,分别应该怎么写?
首先pa是指向含两个char的数组的指针,则如果要访问r,应该是pa[5][1]。同理,ppa是指向3×2的多维数组的指针。所以要访问r,应该是ppa[1][2][1]。
8 函数类型和函数指针类型
函数类型和数组类型类似,做右值使用时自动转换成函数指针类型。
利用指针数组调用函数指针可以使得每个函数只做一件事情,更好地进行现有代码的复用,使代码更容易维护。
9 不完全类型和复杂声明
C语言的类型分为函数类型、对象类型和不完全类型三大类。对象类型又分为标量类型和非标量类型。指针类型属于标量类型,因此也可以做逻辑与、或、非运算的操作数和
if、for、while的控制表达式,NULL指针表示假,非NULL指针表示真。不完全类型是暂时没有完全定义好的类型,编译器不知道这种类型该占几个字节的存储空间。具有不完全类型的变量可以通过多次声明组合成一个完全类型。在分析复杂声明时,要借助
typedef把复杂声明分解成几种基本形式:
T *p;,p是指向T类型的指针。T a[];,a是由T类型的元素组成的数组,但有一个例外,如果a是函数的形参,则相当于T *a;。T1 f(T2, T3...);,f是一个函数,参数类型是T2、T3等等,返回值类型是T1。
第24章:函数接口
1 本章的预备知识
这一节介绍本章的范例代码要用的几个C标准库函数。我们先体会一下这几个函数的接口是怎么设计的,Man Page是怎么写的。
1.1 strcpy与strncpy
strcpy和strncpy这两个函数的作用是把一个字符串拷贝给另一个字符串。
SYNOPSIS中包含了使用这些函数所需要的头文件以及函数的原型,因此接下来直接给出这两个函数的SYNOPSIS部分。
#include <string.h>

char *strcpy(char *dest, const char *src);

char *strncpy(char *dest, const char *src, size_t n);在函数strncpy中,参数n表示从src字符串中拷贝前n个字节到dest。如果字符串src不够n个字节,则补充\0。
习题1:自己实现一个
strcpy函数,尽可能简洁,你能用三行代码写出函数体吗?
这个实现比较简单,因此直接给出函数:
char *strcpy(char *dest, const char *src)
{
    char *addr = dest;
    while((*dest++ =*src++) != '\0');
    return addr;
}
习题2:编一个函数,输入一个字符串,要求做一个新字符串,把其中所有的一个或多个连续的空白字符都压缩为一个空格。这里所说的空白包括空格、
'\t'、'\n'、'\r'。例如原来的字符串是:This Content hoho is ok ok? file system uttered words ok ok ? end.压缩了空白之后就是:
This Content hoho is ok ok? file system uttered words ok ok ? end.实现该功能的函数接口要求符合下述规范:
cchar *shrink_space(char *dest, const char *src, size_t n);各项参数和返回值的含义和
strncpy类似。完成之后,为自己实现的函数写一个Man Page。
这个函数相对比较麻烦,但也不困难,需要考虑到的是压缩时不要出现连续压缩成多个空格的情况。最后函数如下:
char *shrink_space(char *dest, const char *src, size_t n)
{
    char *addr = dest;
    size_t i = 0;

    while((*src != '\0') && (i < n)){
        if((*src == '\t') || (*src == '\n') || (*src == '\r') || (*src == ' ')){
            if((i == 0) || (dest[-1] != ' ')){
                *dest++ = ' ';
                i++;
            }
            src++;
        }
        else{
            *dest++ = *src++;
            i++;
        }
    }

    for(i; i < n; i++){
        *dest++ = '\0';
    }

    return addr;
}
至于Man Page这里就不再赘述,就是将函数的功能,原型,参数的描述,使用时的注意事项等写出来,便于使用者查阅。
1.2 malloc与free
c#include <stdlib.h> void *malloc(size_t size); 返回值:成功返回所分配内存空间的首地址,出错返回NULL void free(void *ptr);
malloc的参数size表示要分配的字节数,如果分配失败(可能是由于系统内存耗尽)则返回NULL。由于malloc函数不知道用户拿到这块内存要存放什么类型的数据,所以返回通用指针void *,用户程序可以转换成其它类型的指针再访问这块内存。malloc函数保证它返回的指针所指向的地址满足系统的对齐要求,例如在32位平台上返回的指针一定对齐到4字节边界,以保证用户程序把它转换成任何类型的指针都能用。动态分配的内存用完之后可以用
free释放掉,传给free的参数正是先前malloc返回的内存块首地址。如果一个程序长年累月运行,并且在循环或递归中调用
malloc分配内存,则必须有free与之配对,分配一次就要释放一次,否则每次循环都分配内存,分配完了又不释放,就会慢慢耗尽系统内存,这种错误称为内存泄漏(Memory Leak)。另外,malloc返回的指针一定要保存好,只有把它传给free才能释放这块内存,如果这个指针丢失了,就没有办法free这块内存了,也会造成内存泄漏。
2 传入参数与传出参数
如果函数接口有指针参数,既可以把指针所指向的数据传给函数使用(称为传入参数),也可以由函数填充指针所指的内存空间,传回给调用者使用(称为传出参数)。有些函数的指针参数同时担当了这两种角色,既是传入参数又是传出参数,这称为Value-result参数。
3 两层指针的参数
两层指针也是指针,同样可以表示传入参数、传出参数或者Value-result参数,只不过该参数所指的内存空间应该解释成一个指针变量。
至于书中提出的问题,其实只要记住函数中的参数是形参,不会影响主函数中的参数,因此在函数中需要通过指针直接改变主函数参数所在地址的值,这样才能改变主函数参数的值。
4 返回值是指针的情况
将书中的程序简单修改成一个c文件,然后我们简单分析一下。
#include <stdio.h>
#include <string.h>

static const char *msg[] = {"Sunday", "Monday", "Tuesday", "Wednesday",
			"Thursday", "Friday", "Saturday"};

char *get_a_day(int idx)
{
     static char buf[20];
     strcpy(buf, msg[idx]);
     return buf;
}

int main(void)
{
     printf("%s %s\n", get_a_day(0), get_a_day(1));
     return 0;
}在这个程序中,由于buf是个静态变量,因此两次调用时实际上是同一个地址,之后打印时%s当然就取的是同一个值。
5 回调函数
如果参数是一个函数指针,调用者可以传递一个函数的地址给实现者,让实现者去调用它,这称为回调函数(Callback Function)。
实际上即调用者给实现者一个回调函数,实现者将指针给回调函数,不需要关心指针到底指向的是什么数据类型,而调用者知道是什么数据类型。
6 可变参数
习题1:实现一个功能更完整的
printf,能够识别%,能够处理%d、%o和%x对应的整数参数。在实现中不许调用printf(3)这个Man Page中描述的任何函数。
这个题稍微有点麻烦,我们拆解一下,首先需要实现的有识别%,然后根据%d或%f选择不同的输出方式。因此这个prinf函数就拆解成3个函数,先给出所实现的函数,之后我们简单分析一些细节问题。
#include <stdio.h>
#include <stdarg.h>

void print_d(int a)
{
    char buf[24];
    int i = 0;

    if(a > 0){
        while (a > 0) {
        buf[i++] = (char)('0' + a % 10);
        a /= 10;
        }
        while (i > 0)
        putchar(buf[--i]);
    }
    else if(a == 0){
        putchar('0');
    }
    else{
        long long x = a;
        putchar('-');
        x = -x;
        while (x > 0) {
        buf[i++] = (char)('0' + x % 10);
        x /= 10;
        }
        while (i > 0)
        putchar(buf[--i]);
    }
}

void print_o(int a)
{
    char buf[24];
    int i = 0;
    unsigned int x = (unsigned int)a;

    if(a != 0){
        while (x > 0) {
            buf[i++] = (char)('0' + x % 8);
            x /= 8;
        }
        while (i > 0)
            putchar(buf[--i]);
    }
    if (a == 0) putchar('0');
}

void print_x(int a)
{
    char buf[24];
    int i = 0;
    unsigned int x = (unsigned int)a;

    if(a != 0){
        while (x > 0) {
            if(x % 16 < 10)
            buf[i++] = (char)('0' + x % 16);
            else{
                switch(x % 16){
                case 10: buf[i++] = 'a';
                    break;
                case 11: buf[i++] = 'b';
                    break;
                case 12: buf[i++] = 'c';
                    break;
                case 13: buf[i++] = 'd';
                    break;
                case 14: buf[i++] = 'e';
                    break;
                case 15: buf[i++] = 'f';
                    break;
                }
            }
            x /= 16;
        }
        while (i > 0)
            putchar(buf[--i]);
    }
    if (a == 0) putchar('0');
}

void myprintf(const char *format, ...)
{
    va_list ap;
    char c;

    va_start(ap, format);
    while (*format) {
	  if(*format != '%'){
        putchar(*format++);
        continue;
      }
      format++;
      switch(*format++){
        case 'd':
            print_d(va_arg(ap, int));
            break;
        case 'o':
            print_o(va_arg(ap, int));
            break;
        case 'x':
            print_x(va_arg(ap, int));
            break;
        }
    }
    va_end(ap);
}

int main()
{
    myprintf("%x", 10);
}printf函数的写法就仿照书中讲的,首先判断字符是否是%,之后判断后面的字符是不是d、o或x。选择不同的打印函数,打印函数的写法则是按照不同的要求,十进制就直接按照正负按位打印;八进制和十六进制则是需要转换成无符号数后按位打印。
第25章:C标准库
1 字符串操作函数
1.1 初始化字符串
c#include <string.h> void *memset(void *s, int c, size_t n); 返回值:s指向哪,返回的指针就指向哪
memset函数把s所指的内存地址开始的n个字节都填充为c的值。通常c的值为0,把一块内存区清零。例如定义char buf[10];,如果它是全局变量或静态变量,则自动初始化为0(位于.bss段),如果它是函数的局部变量,则初值不确定,可以用memset(buf, 0, 10)清零,由malloc分配的内存初值也是不确定的,也可以用memset清零。
1.2 取字符串的长度
c#include <string.h> size_t strlen(const char *s); 返回值:字符串的长度
strlen函数返回s所指的字符串的长度。该函数从s所指的第一个字符开始找'\0'字符,一旦找到就返回,返回的长度不包括'\0'字符在内。
1.3 拷贝字符串
在前面我们学习过strcpy和strncpy两个函数,用来拷贝以'\0'结尾的字符串,接下来书中将介绍memcpy和memmove函数。
c#include <string.h> void *memcpy(void *dest, const void *src, size_t n); void *memmove(void *dest, const void *src, size_t n); 返回值:dest指向哪,返回的指针就指向哪
memcpy函数从src所指的内存地址拷贝n个字节到dest所指的内存地址,和strncpy不同,memcpy并不是遇到'\0'就结束,而是一定会拷贝完n个字节。这里的命名规律是,以str开头的函数处理以'\0'结尾的字符串,而以mem开头的函数则不关心'\0'字符,或者说这些函数并不把参数当字符串看待,因此参数的指针类型是void *而非char *。
memmove也是从src所指的内存地址拷贝n个字节到dest所指的内存地址,虽然叫move但其实也是拷贝而非移动。但是和memcpy有一点不同,memcpy的两个参数src和dest所指的内存区间如果重叠则无法保证正确拷贝,而memmove却可以正确拷贝。字符串的拷贝也可以用
strdup函数,这个函数不属于C标准库,是POSIX标准中定义的,POSIX标准定义了UNIX系统的各种接口,包含C标准库的所有函数和很多其它的系统函数。c#include <string.h> char *strdup(const char *s); 返回值:指向新分配的字符串这个函数调用
malloc动态分配内存,把字符串s拷贝到新分配的内存中然后返回。用这个函数省去了事先为新字符串分配内存的麻烦,但是用完之后要记得调用free释放新字符串的内存。
1.4 连接字符串
c#include <string.h> char *strcat(char *dest, const char *src); char *strncat(char *dest, const char *src, size_t n); 返回值:dest指向哪,返回的指针就指向哪
strcat把src所指的字符串连接到dest所指的字符串后面。strcat和strcpy有同样的问题,调用者必须确保dest缓冲区足够大,否则会导致缓冲区溢出错误。strncat函数通过参数n指定一个长度,就可以避免缓冲区溢出错误。注意这个参数n的含义和strncpy的参数n不同,它并不是缓冲区dest的长度,而是表示最多从src缓冲区中取n个字符(不包括结尾的'\0')连接到dest后面。如果src中前n个字符没有出现'\0',则取前n个字符再加一个'\0'连接到dest后面,所以strncat总是保证dest缓冲区以'\0'结尾,这一点又和strncpy不同,strncpy并不保证dest缓冲区以'\0'结尾。所以,提供给strncat函数的dest缓冲区的大小至少应该是strlen(dest)个字节,才能保证不溢出。
1.5 比较字符串
c#include <string.h> int memcmp(const void *s1, const void *s2, size_t n); int strcmp(const char *s1, const char *s2); int strncmp(const char *s1, const char *s2, size_t n); 返回值:负值表示s1小于s2,0表示s1等于s2,正值表示s1大于s2
memcmp从前到后逐个比较缓冲区s1和s2的前n个字节(不管里面有没有'\0'),如果s1和s2的前n个字节全都一样就返回0,如果遇到不一样的字节,s1的字节比s2小就返回负值,s1的字节比s2大就返回正值。
strcmp把s1和s2当字符串比较,在其中一个字符串中遇到'\0'时结束。
strncmp的比较结束条件是:要么在其中一个字符串中遇到'\0'结束(类似于strcmp),要么比较完n个字符结束(类似于memcmp)。c#include <strings.h> int strcasecmp(const char *s1, const char *s2); int strncasecmp(const char *s1, const char *s2, size_t n); 返回值:负值表示s1小于s2,0表示s1等于s2,正值表示s1大于s2这两个函数和
strcmp/strncmp类似,但在比较过程中忽略大小写,大写字母A和小写字母a认为是相等的。这两个函数不属于C标准库,是POSIX标准中定义的。
1.6 搜索字符串
c#include <string.h> char *strchr(const char *s, int c); char *strrchr(const char *s, int c); 返回值:如果找到字符c,返回字符串s中指向字符c的指针,如果找不到就返回NULL
strchr在字符串s中从前到后查找字符c,找到字符c第一次出现的位置时就返回,返回值指向这个位置,如果找不到字符c就返回NULL。strrchr和strchr类似,但是从右向左找字符c,找到字符c第一次出现的位置就返回。c#include <string.h> char *strstr(const char *haystack, const char *needle); 返回值:如果找到子串,返回值指向子串的开头,如果找不到就返回NULL
strstr在一个长字符串中从前到后找一个子串(Substring),找到子串第一次出现的位置就返回,返回值指向子串的开头,如果找不到就返回NULL。haystack是长字符串,needle是要找的子串。
考虑一下书上提出的问题,如果用两层循环搜索子串的话,外层循环把haystack中的每一个字符的位置依次假定为子串的开头,内层循环从这个位置开始逐个比较haystack和needle的每个字符是否相同。这个算法的复杂度将会非常大,假设haystack的长度为n,needle的长度为m,那么最坏的情况是类似于下面这种情况:haystack有n个'a',needle是m-1个'a'和最末尾的'b'。在这种情况下,将需要比较 次。
1.7 分割字符串
c#include <string.h> char *strtok(char *str, const char *delim); char *strtok_r(char *str, const char *delim, char **saveptr); 返回值:返回指向下一个Token的指针,如果没有下一个Token了就返回NULL参数
str是待分割的字符串,delim是分隔符,可以指定一个或多个分隔符,strtok遇到其中任何一个分隔符就会分割字符串。第一次调用要把字符串首地址传给
strtok的第一个参数,以后每次调用第一个参数只要传NULL就可以了,strtok函数自己会记住上次处理到字符串的什么位置(显然这是通过strtok函数中的一个静态指针变量记住的)。刚才提到在
strtok函数中应该有一个静态指针变量记住上次处理到字符串中的什么位置,所以不需要每次调用时都把字符串中的当前处理位置传给strtok,但是在函数中使用静态变量是不好的,以后会讲到这样的函数是不可重入的。strtok_r函数则不存在这个问题,它的内部没有静态变量,调用者需要自己分配一个指针变量来维护字符串中的当前处理位置,每次调用时把这个指针变量的地址传给strtok_r的第三个参数,告诉strtok_r从哪里开始处理,strtok_r返回时再把新的处理位置写回到这个指针变量中(这是一个Value-result参数)。strtok_r末尾的r就表示可重入(Reentrant),这个函数不属于C标准库,是在POSIX标准中定义的。
习题1:出于练习的目的,
strtok和strtok_r函数非常值得自己动手实现一遍,在这个过程中不仅可以更深刻地理解这两个函数的工作原理,也为以后理解“可重入”和“线程安全”这两个重要概念打下基础。
首先先来实现strtok,由于delim可能是多个分隔符,因此我们需要一个函数来判断当前字符是不是这多个分隔符的其中一个,之后则根据strtok的逻辑功能写出函数即可。接下来给出完整的程序。
#include <stdio.h>

int is_delim(char *p, const char *delim)
{
    const char *all_delim = delim;
    while(*all_delim != '\0'){
        if(*p == *all_delim){
            return 1;
        }
        else{
            all_delim++;
        }
    }
    return 0;
}

char *strtok(char *str, const char *delim)
{
    static char *p;
    char *token;

    if(str != NULL)p = str;
    if(p == NULL)return NULL;
    while(is_delim(p, delim)){
        p++;
    }
    if(*p == '\0')return NULL;

    token = p;

    while(!is_delim(p, delim) && (*p != '\0')){
        p++;
    }
    if(is_delim(p, delim)){
        *p = '\0';
        p++;
    }
    if(*p == '\0')p = NULL;
    return token;
}

int main(void)
{
	char str[] = "root:x::0:root:/root:/bin/bash:";
	char *token;

	token = strtok(str, ":");
	printf("%s\n", token);
	while ( (token = strtok(NULL, ":")) != NULL)
		printf("%s\n", token);

	return 0;
}至于strtok_r则只需要在strtok函数中增加一个参数,且在返回token之前保留当前地址即可。is_delim函数依旧保留即可。
char *strtok_r(char *str, const char *delim, char **saveptr)
{
    char *token;
    char *p;

    if(str != NULL)*saveptr = str;
    p = *saveptr;
    if(p == NULL)return NULL;
    while(is_delim(p, delim)){
        p++;
    }
    if(*p == '\0')return NULL;

    token = p;

    while(!is_delim(p, delim) && (*p != '\0')){
        p++;
    }
    if(is_delim(p, delim)){
        *p = '\0';
        p++;
    }
    if(*p == '\0')p = NULL;

    *saveptr = p;

    return token;
}
习题2:解析URL中的路径和查询字符串。动态网页的URL末尾通常带有查询,例如:
http://www.google.cn/search?complete=1&hl=zh-CN&ie=GB2312&q=linux&meta=
http://www.baidu.com/s?wd=linux&cl=3比如上面第一个例子,
http://www.google.cn/search是路径部分,?号后面的complete=1&hl=zh-CN&ie=GB2312&q=linux&meta=是查询字符串,由五个“key=value”形式的键值对(Key-value Pair)组成,以&隔开,有些键对应的值可能是空字符串,比如这个例子中的键meta。现在要求实现一个函数,传入一个带查询字符串的URL,首先检查输入格式的合法性,然后对URL进行切分,将路径部分和各键值对分别传出,请仔细设计函数接口以便传出这些字符串。如果函数中有动态分配内存的操作,还要另外实现一个释放内存的函数。完成之后,为自己设计的函数写一个Man Page。
这个题表面上不算非常复杂,但实际上有许多需要注意的地方,先把函数给出来,然后分析一下,至于Man Page就省略不写了。
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

typedef struct kv_struct{
    char *key;
    char *value;
}kv_t;

int url_parse(char *str, char **path, kv_t **pairs, size_t *count)
{
    char *kv_all;
    char *p;
    char *q;
    char *kv_every;
    char *save_1 = NULL;
    size_t c = 0;

    p = strchr(str, '?');
    if (p == NULL){
        return 1;
    }

    *p = '\0';
    *path = str;
    kv_all = p + 1;

    q = kv_all;

    while((q = strchr(q, '&')) != NULL){
        c++;
        q++;
    }

    kv_t *arr = malloc((c + 1) * sizeof(kv_t));
    if(arr == NULL)return 2;

    size_t n = 0;

    kv_every = strtok_r(kv_all, "&", &save_1);

    while(kv_every != NULL){
        p = strchr(kv_every, '=');
        if (p == NULL){
            free(arr);
            return 1;
        }
        *p = '\0';
        arr[n].key = kv_every;
        arr[n].value = p + 1;
        n++;

        kv_every = strtok_r(NULL, "&", &save_1);
    }

    *pairs = arr;
    *count = n;
    return 0;
}

void url_free(kv_t *pairs)
{
    free(pairs);
}在写这个函数的时候可以先考虑具体的逻辑,再考虑题目要求传出的接口,比如首先查到第一个'?'所在的地址,然后分成将字符串分成两部分,一部分是路径部分,另一部分是各键值对,之后再对各键值对进行分解,对键值对分解前要分配存储空间,根据键值对的数量和宽度计算要分配多少字节。在逻辑部分写完后,考虑传出接口以及函数的参数类型,针对不同的数据类型选择不同的参数类型即可,比如要传出路径,由于需要把str的地址写给*path,那么函数类型就是char **path。当然分割时也需要考虑所用的分割函数,由于分割层数比较多,因此strtok函数不是一个很好的选择,在分割路径的时候,选择字符串查找函数strchr找到第一个'?',然后直接将它改写成'\0',就能分割成两个部分了;对内层的key和value也采用同样的方式,分割键值对则采用strtok_r即可。
2 标准I/O库函数
2.1 文件的基本概念
文件可分为文本文件(Text File)和二进制文件(Binary File)两种,源文件是文本文件,而目标文件、可执行文件和库文件是二进制文件。文本文件是用来保存字符的,文件中的字节都是字符的某种编码(例如ASCII或UTF-8),用
cat命令可以查看其中的字符,用vi可以编辑其中的字符,而二进制文件不是用来保存字符的,文件中的字节表示其它含义,例如可执行文件中有些字节表示指令,有些字节表示各Section和Segment在文件中的位置,有些字节表示各Segment的加载地址。文本文件是一个模糊的概念。有些时候说文本文件是指用
vi可以编辑出来的文件,例如/etc目录下的各种配置文件,这些文件中只包含ASCII码中的可见字符,而不包含像'\0'这种不可见字符,也不包含最高位是1的非ASCII码字节。从广义上来说,只要是专门保存字符的文件都算文本文件,包含不可见字符的也算,采用其它字符编码(例如UTF-8编码)的也算。
2.2 fopen/fclose
在操作文件之前要用
fopen打开文件,操作完毕要用fclose关闭文件。打开文件就是在操作系统中分配一些资源用于保存该文件的状态信息,并得到该文件的标识,以后用户程序就可以用这个标识对文件做各种操作,关闭文件则释放文件在操作系统中占用的资源,使文件的标识失效,用户程序就无法再操作这个文件了。c#include <stdio.h> FILE *fopen(const char *path, const char *mode); 返回值:成功返回文件指针,出错返回NULL并设置errno
path是文件的路径名,mode表示打开方式。path可以是相对路径也可以是绝对路径,mode表示打开方式是读还是写。如果文件打开成功,就返回一个FILE *文件指针来标识这个文件。以后调用其它函数对文件做读写操作都要提供这个指针,以指明对哪个文件进行操作。
mode参数是一个字符串,由rwatb+六个字符组合而成,r表示读,w表示写,a表示追加(Append),在文件末尾追加数据使文件的尺寸增大。t表示文本文件,b表示二进制文件,有些操作系统的文本文件和二进制文件格式不同,而在UNIX系统中,无论文本文件还是二进制文件都是由一串字节组成,t和b没有区分,用哪个都一样,也可以省略不写。如果省略t和b,rwa+四个字符有以下6种合法的组合:
r:只读,文件必须已存在。w:只写,如果文件不存在则创建,如果文件已存在则把文件长度截断(Truncate)为0字节再重新写,也就是替换掉原来的文件内容。a:只能在文件末尾追加数据,如果文件不存在则创建。r+:允许读和写,文件必须已存在。w+:允许读和写,如果文件不存在则创建,如果文件已存在则把文件长度截断为0字节再重新写。a+:允许读和追加数据,如果文件不存在则创建。在打开一个文件时如果出错,
fopen将返回NULL并设置errno。在程序中应该做出错处理,通常这样写:cif ( (fp = fopen("/tmp/file1", "r")) == NULL) { printf("error open file /tmp/file1!\n"); exit(1); }再说说
fclose函数。c#include <stdio.h> int fclose(FILE *fp); 返回值:成功返回0,出错返回EOF并设置errno把文件指针传给
fclose可以关闭它所标识的文件,关闭之后该文件指针就无效了,不能再使用了。如果fclose调用出错(比如传给它一个无效的文件指针)则返回EOF并设置errno,EOF在stdio.h中定义:c/* End of file character. Some things throughout the library rely on this being -1. */ #ifndef EOF # define EOF (-1) #endif它的值是-1。
fopen调用应该和fclose调用配对,打开文件操作完之后一定要记得关闭。如果不调用fclose,在进程退出时系统会自动关闭文件,但是不能因此就忽略fclose调用。
2.3 stdin/stdout/stderr
我们常用的printf和scanf函数都属于I/O操作,只不过不是对文件进行操作,而是对终端设备进行操作。每个设备都有一个设备文件与之对应,由于UNIX的特性,设备文件也可以像文件一样打开,读写,关闭,使用的函数接口是相同的。
在程序启动时(在
main函数还没开始执行之前)会自动把终端设备打开三次,分别赋给三个FILE *指针stdin、stdout和stderr,这三个文件指针是libc中定义的全局变量,在stdio.h中声明,printf向stdout写,而scanf从stdin读,后面我们会看到,用户程序也可以直接使用这三个文件指针。这三个文件指针的打开方式都是可读可写的,但通常stdin只用于读操作,称为标准输入(Standard Input),stdout只用于写操作,称为标准输出(Standard Output),stderr也只用于写操作,称为标准错误输出(Standard Error),通常程序的运行结果打印到标准输出,而错误提示(例如gcc报的警告和错误)打印到标准错误输出,所以fopen的错误处理写成这样更符合惯例:cif ( (fp = fopen("/tmp/file1", "r")) == NULL) { fputs("Error open file /tmp/file1\n", stderr); exit(1); }通过重定向操作,可以把标准输出重定向到一个常规文件,而标准错误输出仍然对应终端设备,这样就可以把正常的运行结果和错误提示分开,而不是混在一起打印到屏幕了。
2.4 errno函数与perror函数
很多系统函数在错误返回时将错误原因记录在
libc定义的全局变量errno中,每种错误原因对应一个错误码,errno在头文件errno.h中声明,是一个整型变量,所有错误码都是正整数。如果在程序中打印错误信息时直接打印
errno变量,打印出来的只是一个整数值,仍然看不出是什么错误。比较好的办法是用perror或strerror函数将errno解释成字符串再打印。c#include <stdio.h> void perror(const char *s);
perror函数将错误信息打印到标准错误输出,首先打印参数s所指的字符串,然后打印:号,然后根据当前errno的值打印错误原因。大多数系统函数都有一个Side Effect,就是有可能改变
errno变量,所以一个系统函数错误返回后应该马上检查errno,在检查errno之前不能再调用其它系统函数。
strerror函数可以根据错误号返回错误原因字符串。c#include <string.h> char *strerror(int errnum); 返回值:错误码errnum所对应的字符串这个函数返回指向静态内存的指针。有些函数的错误码并不保存在
errno中,而是通过返回值返回,就不能调用perror打印错误原因了,这时strerror就派上了用场。
习题1:在系统头文件中找到各种错误码的宏定义。
在Man Page明确了使用错误码时要用符号名而不是数字,由于错误码众多,具体的符号名和错误原因直接在手册中查找即可,这里就不再给出。
2.5 以字节为单位的I/O函数
fgetc函数从指定的文件中读一个字节,getchar从标准输入读一个字节,调用getchar()相当于调用fgetc(stdin)。c#include <stdio.h> int fgetc(FILE *stream); int getchar(void); 返回值:成功返回读到的字节,出错或者读到文件末尾时返回EOF对于
fgetc函数的使用有以下几点说明:
- 要用
fgetc函数读一个文件,该文件的打开方式必须是可读的。- 系统对于每个打开的文件都记录着当前读写位置在文件中的地址(或者说距离文件开头的字节数),也叫偏移量(Offset)。当文件打开时,读写位置是0,每调用一次
fgetc,读写位置向后移动一个字节,因此可以连续多次调用fgetc函数依次读取多个字节。fgetc成功时返回读到一个字节,本来应该是unsigned char型的,但由于函数原型中返回值是int型,所以这个字节要转换成int型再返回,那为什么要规定返回值是int型呢?因为出错或读到文件末尾时fgetc将返回EOF,即-1,保存在int型的返回值中是0xffffffff,如果读到字节0xff,由unsigned char型转换为int型是0x000000ff,只有规定返回值是int型才能把这两种情况区分开,如果规定返回值是unsigned char型,那么当返回值是0xff时无法区分到底是EOF还是字节0xff。如果需要保存fgetc的返回值,一定要保存在int型变量中,如果写成unsigned char c = fgetc(fp);,那么根据c的值又无法区分EOF和0xff字节了。注意,fgetc读到文件末尾时返回EOF,只是用这个返回值表示已读到文件末尾,并不是说每个文件末尾都有一个字节是EOF(根据上面的分析,EOF并不是一个字节)。
这个地方可能会有疑问,为什么-1会和0xff相同呢,是因为无符号转换是取模运算,因此在8位无符号数中-1和255是同一个值,即0xff。
fputc函数向指定的文件写一个字节,putchar向标准输出写一个字节,调用putchar(c)相当于调用fputc(c, stdout)。c#include <stdio.h> int fputc(int c, FILE *stream); int putchar(int c); 返回值:成功返回写入的字节,出错返回EOF对于
fputc函数的使用也要说明几点:
- 要用
fputc函数写一个文件,该文件的打开方式必须是可写的(包括追加)。- 每调用一次
fputc,读写位置向后移动一个字节,因此可以连续多次调用fputc函数依次写入多个字节。但如果文件是以追加方式打开的,每次调用fputc时总是将读写位置移到文件末尾然后把要写入的字节追加到后面。
习题1:编写一个简单的文件复制程序。
c$ ./mycp dir1/fileA dir2/fileB运行这个程序可以把
dir1/fileA文件拷贝到dir2/fileB文件。注意各种出错处理。
这个程序的思路是先判断传入的参数个数是否正确,如果不对就提醒格式然后返回,之后就是以读方式打开dir1/fileA文件,以写方式打开dir2/fileB文件,用fgetc和fputc按字节拷贝文件,最后关闭两个文件。
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>

int main(int argc, char *argv[])
{
    FILE *fp1;
    FILE *fp2;

    int c;

   if(argc != 3){
    printf("Usage: %s src des\n", argv[0]);
    return 1;
   }

   if((fp1 = fopen(argv[1], "r")) == NULL){
        perror("open file src");
        exit(1);
   }

    if((fp2 = fopen(argv[2], "w")) == NULL){
        perror("open file des");
        fclose(fp1);
        exit(1);
   }

    while((c = fgetc(fp1)) != EOF){
        fputc(c, fp2);
    }

    fclose(fp1);
    fclose(fp2);

    return 0;
}
习题2:虽然我说
getchar要读到换行符才返回,但上面的程序并没有提供证据支持我的说法,如果看成每敲一个键getchar就返回一次,也能解释程序的运行结果。请写一个小程序证明getchar确实是读到换行符才返回的。
这个题非常简单,只需要在getchar之前打印一句话,然后在getchar之后再打印一句话,如果每敲一个键就返回一次,那么应该直接打印后面的句子,反之后面的句子就不能打印出来。
#include <stdio.h>

int main()
{
    int c;

    printf("before getchar\n");

    c = getchar();

    printf("%d\n", c);

    printf("after getchar\n");

    return 0;
}
2.6 操作读写位置的函数
rewind函数可以把读写位置移到文件开头,另外还有两个函数可以操作读写位置,fseek可以任意移动读写位置,ftell可以返回当前的读写位置。c#include <stdio.h> int fseek(FILE *stream, long offset, int whence); 返回值:成功返回0,出错返回-1并设置errno long ftell(FILE *stream); 返回值:成功返回当前读写位置,出错返回-1并设置errno void rewind(FILE *stream);
fseek的whence和offset参数共同决定了读写位置移动到何处,whence参数的含义如下:
SEEK_SET:从文件开头移动offset个字节。SEEK_CUR:从当前位置移动offset个字节。SEEK_END:从文件末尾移动offset个字节。
offset可正可负,负值表示向前(向文件开头的方向)移动,正值表示向后(向文件末尾的方向)移动,如果向前移动的字节数超过了文件开头则出错返回,如果向后移动的字节数超过了文件末尾,再次写入时将增大文件尺寸,从原来的文件末尾到fseek移动之后的读写位置之间的字节都是0。
2.7 以字符串为单位的I/O函数
fgets从指定的文件中读一行字符到调用者提供的缓冲区中,gets从标准输入读一行字符到调用者提供的缓冲区中。c#include <stdio.h> char *fgets(char *s, int size, FILE *stream); char *gets(char *s); 返回值:成功时s指向哪返回的指针就指向哪,出错或者读到文件末尾时返回NULL
由于gets函数本身设计的问题,在编程中应该避免使用。
fgets函数,参数s是缓冲区的首地址,size是缓冲区的长度,该函数从stream所指的文件中读取以'\n'结尾的一行(包括'\n'在内)存到缓冲区s中,并且在该行末尾添加一个'\0'组成完整的字符串。如果文件中的一行太长,
fgets从文件中读了size-1个字符还没有读到'\n',就把已经读到的size-1个字符和一个'\0'字符存入缓冲区,文件中剩下的半行可以在下次调用fgets时继续读。如果一次
fgets调用在读入若干个字符后到达文件末尾,则将已读到的字符串加上'\0'存入缓冲区并返回,如果再次调用fgets则返回NULL,可以据此判断是否读到文件末尾。注意,对于
fgets来说,'\n'是一个特别的字符,而'\0'并无任何特别之处,如果读到'\0'就当作普通字符读入。如果文件中存在'\0'字符(或者说0x00字节),调用fgets之后就无法判断缓冲区中的'\0'究竟是从文件读上来的字符还是由fgets自动添加的结束符,所以fgets只适合读文本文件而不适合读二进制文件,并且文本文件中的所有字符都应该是可见字符,不能有'\0'。
2.8 以记录为单位的I/O函数
c#include <stdio.h> size_t fread(void *ptr, size_t size, size_t nmemb, FILE *stream); size_t fwrite(const void *ptr, size_t size, size_t nmemb, FILE *stream); 返回值:读或写的记录数,成功时返回的记录数等于nmemb,出错或读到文件末尾时返回的记录数小于nmemb,也可能返回0
fread和fwrite用于读写记录,这里的记录是指一串固定长度的字节,比如一个int、一个结构体或者一个定长数组。参数size指出一条记录的长度,而nmemb指出要读或写多少条记录,这些记录在ptr所指的内存空间中连续存放,共占sizenmemb个字节,fread从文件stream中读出sizenmemb个字节保存到ptr中,而fwrite把ptr中的sizenmemb个字节写到文件stream中。
nmemb是请求读或写的记录数,fread和fwrite返回的记录数有可能小于nmemb指定的记录数。例如当前读写位置距文件末尾只有一条记录的长度,调用fread时指定nmemb为2,则返回值为1。如果当前读写位置已经在文件末尾了,或者读文件时出错了,则fread返回0。如果写文件时出错了,则fwrite的返回值小于nmemb指定的值。
2.9 格式化I/O函数
printf和scanf函数有很多种形式,首先看printf函数的各种形式。c#include <stdio.h> int printf(const char *format, ...); int fprintf(FILE *stream, const char *format, ...); int sprintf(char *str, const char *format, ...); int snprintf(char *str, size_t size, const char *format, ...); include <stdarg.h> int vprintf(const char *format, va_list ap); int vfprintf(FILE *stream, const char *format, va_list ap); int vsprintf(char *str, const char *format, va_list ap); int vsnprintf(char *str, size_t size, const char *format, va_list ap); 返回值:成功返回格式化输出的字节数(不包括字符串的结尾'\0'),出错返回一个负值
printf格式化打印到标准输出,而fprintf打印到指定的文件stream中。sprintf并不打印到文件,而是打印到用户提供的缓冲区str中并在末尾加'\0',由于格式化后的字符串长度很难预计,所以很可能造成缓冲区溢出,用snprintf更好一些,参数size指定了缓冲区长度,如果格式化后的字符串长度超过缓冲区长度,snprintf就把字符串截断到size-1字节,再加上一个'\0'写入缓冲区,也就是说snprintf保证字符串以'\0'结尾。snprintf的返回值是格式化后的字符串长度(不包括结尾的'\0'),如果字符串被截断,返回的是截断之前的长度,把它和实际缓冲区中的字符串长度相比较就可以知道是否发生了截断。上面列出的后四个函数在前四个函数名的前面多了个
v,表示可变参数不是以...的形式传进来,而是以va_list类型传进来。现在总结一下
printf格式化字符串中的转换说明的有哪些写法。在这里只列举几种常用的格式,其它格式请参考Man Page。每个转换说明以%号开头,以转换字符结尾,我们以前用过的转换说明仅包含%号和转换字符,例如%d、%s,其实在这两个字符中间还可以插入一些可选项。
选项 描述 # 八进制前面加0(转换字符为o),十六进制前面加0x(转换字符为x)或0X(转换字符为X)。 - 格式化后的内容居左,右边可以留空格。 宽度 用一个整数指定格式化后的最小长度,如果格式化后的内容没有这么长,可以在左边留空格,如果前面指定了 -号就在右边留空格。宽度有一种特别的形式,不指定整数值而是写成一个*号,表示取一个int型参数作为宽度。. 用于分隔上一条提到的最小长度和下一条要讲的精度。 精度 用一个整数表示精度,对于字符串来说指定了格式化后保留的最大长度,对于浮点数来说指定了格式化后小数点右边的位数,对于整数来说指定了格式化后的最小位数。精度也可以不指定整数值而是写成一个 *号,表示取下一个int型参数作为精度。字长 对于整型参数, hh、h、l、ll分别表示是char、short、long、long long型的字长,至于是有符号数还是无符号数则取决于转换字符;对于浮点型参数,L表示long double型的字长。常用的转换字符有:
转换字符 描述 d i 取 int型参数格式化成有符号十进制表示,如果格式化后的位数小于指定的精度,就在左边补0。o u x X 取 unsigned int型参数格式化成无符号八进制(o)、十进制(u)、十六进制(x或X)表示,x表示十六进制数字用小写abcdef,X表示十六进制数字用大写ABCDEF,如果格式化后的位数小于指定的精度,就在左边补0。c 取 int型参数转换成unsigned char型,格式化成对应的ASCII码字符。s 取 const char *型参数所指向的字符串格式化输出,遇到'\0'结束,或者达到指定的最大长度(精度)结束。p 取 void *型参数格式化成十六进制表示。相当于%#x。f 取 double型参数格式化成[-]ddd.ddd这样的格式,小数点后的默认精度是6位。e E 取 double型参数格式化成[-]d.ddde±dd(转换字符是e)或[-]d.dddE±dd(转换字符是E)这样的格式,小数点后的默认精度是6位,指数至少是两位。g G 取 double型参数格式化,精度是指有效数字而非小数点后的数字,默认精度是6。如果指数小于-4或大于等于精度就按%e(转换字符是g)或%E(转换字符是G)格式化,否则按%f格式化。小数部分的末尾0去掉,如果没有小数部分,小数点也去掉。% 格式化成一个%。 下面看
scanf函数的各种形式。c#include <stdio.h> int scanf(const char *format, ...); int fscanf(FILE *stream, const char *format, ...); int sscanf(const char *str, const char *format, ...); #include <stdarg.h> int vscanf(const char *format, va_list ap); int vsscanf(const char *str, const char *format, va_list ap); int vfscanf(FILE *stream, const char *format, va_list ap); 返回值:返回成功匹配和赋值的参数个数,成功匹配的参数可能少于所提供的赋值参数,返回0表示一个都不匹配,出错或者读到文件或字符串末尾时返回EOF并设置errno
scanf从标准输入读字符,按格式化字符串format中的转换说明解释这些字符,转换后赋给后面的参数,后面的参数都是传出参数,因此必须传地址而不能传值。fscanf从指定的文件stream中读字符,而sscanf从指定的字符串str中读字符。后面三个以v开头的函数的可变参数不是以...的形式传进来,而是以va_list类型传进来。现在总结一下
scanf的格式化字符串和转换说明,这里也只列举几种常用的格式,其它格式请参考Man Page。scanf用输入的字符去匹配格式化字符串中的字符和转换说明,如果成功匹配一个转换说明,就给一个参数赋值,如果读到文件或字符串末尾就停止,或者如果遇到和格式化字符串不匹配的地方就停止。如果遇到不匹配的地方而停止,scanf的返回值可能小于赋值参数的个数,文件的读写位置指向输入中不匹配的地方,下次调用库函数读文件时可以从这个位置继续。格式化字符串中包括:
- 空格或
Tab,在处理过程中被忽略。- 普通字符(不包括
%),和输入字符中的非空白字符相匹配。输入字符中的空白字符是指空格、Tab、\r、\n、\v、\f。- 转换说明,以
%开头,以转换字符结尾,中间也有若干个可选项。转换说明中的可选项有:
*号,表示这个转换说明只是用来匹配一段输入字符,但匹配结果并不赋给后面的参数。- 用一个整数指定的宽度
N。表示这个转换说明最多匹配N个输入字符,或者匹配到输入字符中的下一个空白字符结束。- 对于整型参数可以指定字长,有
hh、h、l、ll(也可以写成一个L),含义和printf相同。但l和L还有一层含义,当转换字符是e、f、g时,表示赋值参数的类型是float *而非double *,这一点跟printf不同,这时前面加上l或L分别表示double *或long double *型。常用的转换字符有:
转换字符 描述 d 匹配十进制整数(开头可以有负号),赋值参数的类型是 int *。i 匹配整数(开头可以有负号),赋值参数的类型是 int *,如果输入字符以0x或0X开头则匹配十六进制整数,如果输入字符以0开头则匹配八进制整数。o u x 匹配八进制、十进制、十六进制整数(开头可以有负号),赋值参数的类型是 unsigned int *。c 匹配一串字符,字符的个数由宽度指定,缺省宽度是1,赋值参数的类型是 char *,末尾不会添加'\0'。如果输入字符的开头有空白字符,这些空白字符并不被忽略,而是保存到参数中,要想跳过开头的空白字符,可以在格式化字符串中用一个空格去匹配。s 匹配一串非空白字符,从输入字符中的第一个非空白字符开始匹配到下一个空白字符之前,或者匹配到指定的宽度,赋值参数的类型是 char *,末尾自动添加'\0'。e f g 匹配符点数(开头可以有负号),赋值参数的类型是 float *,也可以指定double *或long double *的字长。% 转换说明 %%匹配一个字符%,不做赋值。
2.10 C标准库的I/O缓冲区
实际上,在用户通过I/O函数读写时,C标准库会分配缓冲区用来加速读写操作,当然,如果用户想要立即将缓冲区中的数据传入内核,让内核写入设备,这称为Flush操作,C标准库也提供了相应的库函数fflush,fclose函数在关闭文件之前也会做Flush操作。
C标准库的I/O缓冲区有三种类型:全缓冲、行缓冲和无缓冲。当用户程序调用库函数做写操作时,不同类型的缓冲区具有不同的特性。
- 全缓冲:如果缓冲区写满了就写回内核。常规文件通常是全缓冲的。
- 行缓冲:如果用户程序写的数据中有换行符就把这一行写回内核,或者如果缓冲区写满了就写回内核。标准输入和标准输出对应终端设备时通常是行缓冲的。
- 无缓冲:用户程序每次调库函数做写操作都要通过系统调用写回内核。标准错误输出通常是无缓冲的,这样用户程序产生的错误信息可以尽快输出到设备。
除了写满缓冲区、写入换行符之外,行缓冲还有一种情况会自动做Flush操作。如果:
- 用户程序调用库函数从无缓冲的文件中读取。
- 或者从行缓冲的文件中读取,并且这次读操作会引发系统调用从内核读取数据。
那么在读取之前会自动Flush所有行缓冲。
flush函数如下。作为一个特例,调用fflush(NULL)可以对所有打开文件的I/O缓冲区做Flush操作。c#include <stdio.h> int fflush(FILE *stream); 返回值:成功返回0,出错返回EOF并设置errno
3 数值字符串转换函数
c#include <stdlib.h> int atoi(const char *nptr); double atof(const char *nptr); 返回值:转换结果
atoi把一个字符串开头可以识别成十进制整数的部分转换成int型,相当于下面要讲的strtol(nptr, (char **) NULL, 10);。使用atoi函数不能检查出错的情况。下面要讲的strtol函数可以设置errno,因此可以检查出错的情况,在严格的场合下应该用strtol,而atoi用起来更简便,所以也很常用。
atof把一个字符串开头可以识别成浮点数的部分转换成double型,相当于下面要讲的strtod(nptr, (char **) NULL);。字符串开头可以识别的浮点数格式和C语言的浮点数常量相同。atof也不能检查出错的情况,而strtod可以。c#include <stdlib.h> long int strtol(const char *nptr, char **endptr, int base); double strtod(const char *nptr, char **endptr); 返回值:转换结果,出错时设置errno
strtol是atoi的增强版,主要体现在这几方面:
- 不仅可以识别十进制整数,还可以识别其它进制的整数,取决于
base参数。endptr是一个传出参数,函数返回时指向后面未被识别的第一个字符。可以据此判断这种出错的情况,而这是atoi处理不了的。- 如果字符串中的整数值超出
long int的表示范围(上溢或下溢),则strtol返回它所能表示的最大(或最小)整数,并设置errno为ERANGE。
strtod是atof的增强版,增强的功能和strtol类似。
4 分配内存的函数
除了
malloc之外,C标准库还提供了另外两个在堆空间分配内存的函数,它们分配的内存同样由free释放。c#include <stdlib.h> void *calloc(size_t nmemb, size_t size); void *realloc(void *ptr, size_t size); 返回值:成功返回所分配内存空间的首地址,出错返回NULL
calloc的参数很像fread/fwrite的参数,分配nmemb个元素的内存空间,每个元素占size字节,并且calloc负责把这块内存空间用字节0填充,而malloc并不负责把分配的内存空间清零。 有时候用malloc或calloc分配的内存空间使用了一段时间之后需要改变它的大小,一种办法是调用malloc分配一块新的内存空间,把原内存空间中的数据拷到新的内存空间,然后调用free释放原内存空间。使用realloc函数简化了这些步骤,把原内存空间的指针ptr传给realloc,通过参数size指定新的大小(字节数),realloc返回新内存空间的首地址,并释放原内存空间。新内存空间中的数据尽量和原来保持一致,如果size比原来小,则前size个字节不变,后面的数据被截断,如果size比原来大,则原来的数据全部保留,后面长出来的一块内存空间未初始化(realloc不负责清零)。注意,参数ptr要么是NULL,要么必须是先前调用malloc、calloc或realloc返回的指针,不能把任意指针传给realloc要求重新分配内存空间。作为两个特例,如果调用realloc(NULL, size),则相当于调用malloc(size),如果调用realloc(ptr, 0),ptr不是NULL,则相当于调用free(ptr)。c#include <alloca.h> void *alloca(size_t size); 返回值:返回所分配内存空间的首地址,如果size太大导致栈空间耗尽,结果是未定义的参数
size是请求分配的字节数,alloca函数不是在堆上分配空间,而是在调用者函数的栈帧上分配空间,当调用者函数返回时自动释放栈帧,所以不需要free。
第26章:链表、二叉树和哈希表
1 链表
1.1 单链表
每个链表有一个头指针,通过头指针可以找到第一个节点,每个节点都可以通过指针域找到它的后继,最后一个节点的指针域为
NULL,表示没有后继。链表在内存中的布局是不规则的,不支持随机访问,只能通过前一个元素的指针域得知后一个元素的地址,因此只能从头指针开始顺序访问各节点。 以下代码实现了单链表的基本操作。c/* linkedlist.h */ #ifndef LINKEDLIST_H #define LINKEDLIST_H typedef struct node *link; struct node { unsigned char item; link next; }; link make_node(unsigned char item); void free_node(link p); link search(unsigned char key); void insert(link p); void delete(link p); void traverse(void (*visit)(link)); void destroy(void); void push(link p); link pop(void); #endifc/* linkedlist.c */ #include <stdlib.h> #include "linkedlist.h" static link head = NULL; link make_node(unsigned char item) { link p = malloc(sizeof *p); p->item = item; p->next = NULL; return p; } void free_node(link p) { free(p); } link search(unsigned char key) { link p; for (p = head; p; p = p->next) if (p->item == key) return p; return NULL; } void insert(link p) { p->next = head; head = p; } void delete(link p) { link pre; if (p == head) { head = p->next; return; } for (pre = head; pre; pre = pre->next) if (pre->next == p) { pre->next = p->next; return; } } void traverse(void (*visit)(link)) { link p; for (p = head; p; p = p->next) visit(p); } void destroy(void) { link q, p = head; head = NULL; while (p) { q = p; p = p->next; free_node(q); } } void push(link p) { insert(p); } link pop(void) { if (head == NULL) return NULL; else { link p = head; head = head->next; return p; } }
对上面的程序的各个函数的功能可以很容易的理解对链表操作的过程,这里不再详细解释。如果类比来说,单链表就像连续的藏宝图,其中head指向第一张藏宝图的位置,之后的每个藏宝图都有数据和下一个藏宝图的地址,因此如果要寻找某个数据,需要从head开始向后一直寻找。
如果仅在链表的头部使用用insert和delete函数就能把链表当成堆栈来使用,与用数组实现的堆栈相比,链表不需要提前固定容量,而是按需进行分配,而且没有满的概念,可以进行扩容或缩减。但是每个节点都要依靠指针,内存开销更大。
习题1:修改
insert函数实现插入排序的功能,链表中的数据按从小到大排列,每次插入数据都要在链表中找到合适的位置再插入。在“折半查找”中我们看到,如果数组中的元素是有序排列的,可以用折半查找算法更快地找到某个元素,想一想如果链表中的节点是有序排列的,是否适用折半查找算法?为什么?
首先修改insert函数,需要遍历整个链表,并且记录前一个节点,如果当前节点大于要插入节点的值,则让前一个节点指向插入节点,然后插入节点指向当前节点,如果是空链表、链表所有值都小于插入节点的值和链表的第一个值就大于要插入的值这三种情况,则需要额外进行处理。
void insert(link p)
{
    link q = head;
    link pre = NULL;
    if(q == NULL){
        head = p;
        p->next = NULL;
        return;
    }
    for(q = head; q; q = q->next){
        if((q == head) && (q->item > p->item)){
            head = p;
            p->next = q;
            return;
        }
        else if((q->item > p->item)){
            p->next = q;
            pre->next = p;
            return;
        }
        pre = q;
    }
    if(q == NULL){
        pre->next = p;
        p->next = NULL;
    }
    return;
}
当然,即使链表中的值是有序排列的,依旧不能运用折半查找,就是因为前面提到的链表不支持随机访问,只能从前往后访问。
习题2:基于单链表实现队列的
enqueue和dequeue操作。在链表的末尾再维护一个指针tail,在tail处enqueue,在head处dequeue。想一想能不能反过来,在head处enqueue而在tail处dequeue?
先写enqueue函数,当链表为空链表时,head和tail都指向p;若链表不为空,只需要让tail处的节点指向p,然后让tail指向p即可。
void enqueue(link p)
{
    p->next = NULL;
    if(head == NULL)head = p;
    else tail->next = p;
    tail = p;
}当然,在写dequeue函数的时候,也需要考虑空链表和链表中只有一个节点的情况,空链表直接退出,队列中只有一个节点时,出队需要额外更改tail。
link dequeue(void)
{
    link p = head;
    if(head == NULL){
        exit(1);
    }
    head = p->next;
    if(head == NULL)tail = NULL;
    p->next = NULL;
    return p;
}至于能不能反过来,在head处enqueue而在tail处dequeue。实际上从逻辑上讲是可以的,但是存在一定的问题,在head处入队比较容易,但是在tail处出队就有点问题了,由于不知道tail的前驱是谁,因此出队需要遍历整个队列找到出队节点的前驱,使tail指向前驱,原本时间复杂度为 的队列变成了时间复杂度为 的队列。
习题3:实现函数
void reverse(void);将单链表反转。如下图所示。
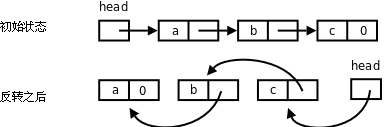
如果要将单链表反转,则需要在处理每个节点时提前存储下一个节点,因为要更改当前节点的指向,而需要原来链表的下一个节点去寻找下一个该处理的节点,处理好这个问题就能完成这个习题了。
void reverse(void)
{
    link prev = NULL;
    link cur;
    link nxt;

    for(cur = head; cur; cur = nxt){
        nxt = cur->next;
        cur->next = prev;
        prev = cur;
    }
    head = prev;
}
1.2 双向链表
双向链表所解决的问题就是上面提到的需要前驱的情况,在每个节点都额外维护一个指向前驱的指针。正是有了这个指向前驱的指针,双向链表在首尾插入或者删除节点的时间复杂度都是 。也解决了在单向链表中不能在head处enqueue而在tail处dequeue的情况。
为了解决出现的特殊情况,比如空链表等,可以在链表头尾添加两个Sentinel节点,这两个节点和普通节点没什么区别,只是不存储数据。这样在删除第一个节点的时候就不用判断特殊情况了,head始终存在,不会出现NULL的情况。
如果要实现环形队列,则在双向列表的基础上将首尾相接即可。
1.3 静态链表
由于数组是需要提前分配空间的,且数组的各个数据之间是通过数组的下标连接的,这种形式的链表称为静态链表。
1.4 本节综合练习
习题1:Josephus是公元1世纪的著名历史学家,相传在一次战役中他和另外几个人被围困在山洞里,他们宁死不屈,决定站成一圈,每次数到三个人就杀一个,直到全部死光为止。Josephus和他的一个朋友不想死,于是串通好了站在适当的位置上,最后只剩下他们俩的时候这个游戏就停止了。如果一开始的人数为N,每次数到M个人就杀一个,那么要想不死应该站在什么位置呢?这个问题比较复杂,《具体数学》的1.3节研究了Josephus问题的解,有兴趣的读者可以参考。现在我们做个比较简单的练习,用链表模拟Josephus他们玩的这个游戏,N和M作为命令行参数传入,每个人的编号依次是1~N,打印每次被杀者的编号,打印最后一个幸存者的编号。
这个题其实就是构建一个环形链表,然后按照题意删除节点,直到剩余最后一个节点就是幸存者。唯一可能出现问题的就是利用插入构建环形链表时最后一个节点实际连接的是Sentinel节点,导致删除时出现问题。
#include <stdio.h>
#include <stdlib.h>

#define N 2
#define M 3

typedef struct node *link;
struct node {
	int item;
	link prev,next;
};

struct node sentinel = {0, &sentinel, &sentinel};

static link head = &sentinel;

link make_node(int item)
{
    link p = malloc(sizeof *p);
    p->item = item;
    p->prev = NULL;
    p->next = NULL;

    return p;
}

void insert(link p)
{
    p->next = head->next;
    head->next->prev = p;
    head->next = p;
    p->prev = head;
}

void delete(link p)
{
    p->prev->next = p->next;
    p->next->prev = p->prev;
    p->prev = NULL;
    p->next = NULL;
}

int main()
{
    int i;
    int j = 1;
    int revivor = N;
    link next_node;

    for(i = N; i > 0; i--){
        insert(make_node(i));
    }
    head->prev->next = head->next;
    head->next->prev = head->prev;

    link cur = head->next;

    while(revivor != 1){
        if(j == M){
            next_node = cur->next;
            printf("%d is dead\n",cur->item);
            delete(cur);
            revivor = revivor - 1;
            cur = next_node;
            j = 1;
        }
        else {
            cur = cur->next;
            j = j + 1;
        }
    }
    printf("The survivor is %d\n",cur->item);
}